6.2.1. Jednorodny proces Poissona na półprostej
Definicja 6.3
Rozważmy niezależne zmienne losowe W1,…,Wk,…
o jednakowym rozkładzie wykładniczym, Xi∼Exλ i
utwórzmy kolejne sumy
|
T0=0,T1=W1,T2=W1+W2,…,Tk=W1+⋯+Wk,… |
|
Niech, dla t≥0,
Rodzinę zmiennych losowych Nt nazywamy procesem Poissona.
Proces Poissona dobrze jest wyobrażać sobie jako losowy zbiór punktów
na półprostej: T1,T2,…,Tk,…. Zmienna Nt
oznacza liczbę punktów, które ,,wpadły” w odcinek ]0,t]. Wygodnie będzie
używać symbolu
dla oznaczenia liczby punktów, które ,,wpadły” w odcinek ]s,t].
Stwierdzenie 6.1
Jeśli Nt jest procesem Poissona, to
Dowód
Zauważmy, że
Wobec tego ze wzoru na prawdopodobieństwo całkowite wynika, że
|
P(N(t)=k)=P(Tk≤t,Tk+1>t)=∫0tP(Tk+1>t|Tk=s)fTk(s)ds=∫0tP(Wk+1>t-s|Tk=s)fTk(s)ds=∫0te-λt-sλkΓksk-1e-λsds=e-λtλkΓk∫0tsk-1ds=e-λtλkk-1!tkk=e-λtλtkk!. |
|
∎
Oczywiście ENt=λt. Liczba
jest nazywana intensywnością procesu.
Stwierdzenie 6.2
Jeśli
to zmienne losowe Nt1,Nt1,t2,… są niezależne i każda
z nich ma rozkład Poissona:
|
Nti-1,ti∼Poissλti-ti-1. |
|
Dowód
Pokażemy, że warunkowo, dla Nt1=k, ciąg zmiennych losowych
|
Tk+1-t1,Wk+2,Wk+3…,jest iid∼Exλ. |
|
Wynika to z własności braku pamięci rozkładu wykładniczego.
W istocie, dla ustalonych Nt1=k i Sk=s mamy
|
P(Tk+1-t1>t|N(t1)=k,Tk=s)=P(Tk+1-t1>t|Tk=s,Tk+1>t1)=P(Wk+1>t1+t-s|Wk+1>t1-s)=P(Wk+1>t)=e-λt. |
|
Fakt, że zmienne Wk+2,Wk+3… są niezależne od zdarzenia
Nt1=k jest oczywisty.
Pokazaliśmy w ten sposób, że losowy zbiór punktów
Tk+1-t1,Tk+2-t1,… ma (warunkowo, dla
Nt1=k) taki sam rozkład prawdopodobieństwa, jak
T1,T2,…. Proces Poissona obserwowany od
momentu t1 jest kopią wyjściowego procesu. Wynika stąd w szczególności,
że zmienna losowa Nt2,t1 jest niezależna od Nt1 i Nt2,t1∼Poissλt2-t1. Dalsza część dowodu przebiega
analogicznie i ją pominiemy.
∎
Metoda generowania procesu Poisson oparta na Definicji 6.3 jest raczej oczywista. Zauważmy jednak, że nie jest to jedyna
metoda. Inny sposób generowania (i inny sposób patrzenia na proces Poissona)
jest związany z następującym faktem.
Stwierdzenie 6.3
Warunkowo, dla Nt=n, ciąg zmiennych losowych
ma rozkład taki sam, jak ciąg statystyk pozycyjnych
z rozkładu U0,t.
Dowód
Z Wniosku 5.1 wynika, że warunkowo, dla Tn=s,
Innymi słowy wektor losowy T1,…,Tn-1 ma taki rozkład, jak
n-1 statystyk pozycyjnych z U0,s.
Obliczmy warunkową gęstość zmiennej losowej Tn, jeśli Nt=n:
|
fTn(s|N(t)=n)=P(N(t)=n|Tn=s)fTn(s)PNt=n=P(Wn+1>t-s)fTn(s)PN=n=e-λt-sλn/n-1!sn-1e-λse-λtλtn/n!=nsn-1tn. |
|
A zatem warunkowo, dla Nt=n, zmienna losowa Tn/t
ma rozklad Betan,1 i w konsekwencji (przypomnijmy sobie algorytm generowania zmiennych o rozkładzie Dirichleta)
|
W1t,…,Wnt,t-Tnt∼Dir1,…,1︸n+1. |
|
Innymi słowy wektor losowy T1,…,Tn-1,Tn ma taki rozkład, jak
n statystyk pozycyjnych z U0,t.
∎
Wynika stąd następujący sposób generowania procesu Poissona na przedziale
0,t.
| Gen N∼Poissλt |
| for i=1 to N do Gen Ui∼U0,t; |
| Sort U1,…,UN |
| T1,…,TN:=U1:N,…,UN:N |
Co ważniejsze, Stwierdzenia 6.1, 6.2 i
6.3 wskazują, jak powinny wyglądać uogólnienia procesu
Poissona i jak generować takie ogólniejsze procesy. Zanim tym się zajmiemy, zróbmy
dygresję i podajmy twierdzenie charakteryzujące ,,zwykły” proces Poissona.
Nie jest ono bezpośrednio używane w symulacjach, ale wprowadza pewien ważny sposób
określania procesów, który ułatwia zrozumienie łańcuchów Markowa z czasem ciągłym
i jest bardzo użyteczny w probabilistycznym modelowaniu zjawisk.
Twierdzenie 6.1
Załóżmy, że Nt:t⩾0 jest procesem o wartościach w 0,1,2,…, stacjonarnych i niezależnych przyrostach (to znaczy Nt-Ns jest niezależne od Nu,u≤s i ma rozkład zależny tylko od t-s dla dowolnych 0<s<t) oraz, że
trajektorie Nt są prawostronnie ciągłymi funkcjami mającymi lewostronne granice (prawie na pewno).
Jeżeli N0=0 i spełnione są następujące warunki:
to N(⋅) jest jednorodnym procesem Poissona z intensywnością λ
Bardzo prosto można zauważyć, że proces Poissona Nt:t⩾0 o intensywności λ ma własności wymienione w Twierdzeniu 6.1. Ciekawe jest, że te własności w pełni charakteryzują proces Poissona.
Dowód Tw. 6.1 – szkic
Pokażemy tylko, że
|
pnt:=PNt=n=e-λtλtnn!. |
|
Najpierw zajmiemy się funkcją p0t=PNt=0.
Z niezależności i jednorodności przyrostów wynika tożsamość
Stąd
|
p0t+h-p0th=p0h-1hp0t=-p1hh-∑i=2∞pihhp0h. |
|
Przejdźmy do granicy z h→0 i skorzystajmy z własności (i) i (ii). Dostajemy proste
równanie różniczkowe:
Rozwiązanie tego równania z warunkiem początkowym p00=1 jest funkcja
Bardzo podobnie obliczamy kolejne funkcje pn. Postępujemy rekurencyjnie: zakładamy, że
znamy pn-1 i układamy równanie różniczkowe dla funkcji pn. Podobnie jak poprzednio,
|
pnt+h=pntp0h+pn-1tp1h+∑i=2npn-1tpih, |
|
a zatem
|
pnt+h-pnth=p0h-1hpnt+p1hhpn-1t+1h∑i=2npn-itpih. |
|
Korzystając z własności (i) i (ii) otrzymujemy równanie
To równanie można rozwiązać metodą uzmiennienia stałej: poszukujemy rozwiązania postaci
pnt=cte-λt. Zakładamy przy tym indukcyjnie, że
pn-1t=λtn-1e-λt/n-1! i mamy oczywisty warunek początkowy
pn0=0. Stąd już łatwo dostać dowodzony wzór na pn.
Na koniec zauważmy, że z postaci funkcji p0 łatwo wywnioskować
jaki ma rozkład zmienna T1=inft:Nt>0. Istotnie, PT1>t=PNt=0 =p0(t)=e-λt.
∎
Własności (i) i (ii), w połączeniu z jednorodnością przyrostów można przepisać w następującej
sugestywnej formie:
|
P(N(t+h)=n+1|N(t)=n)=λh+o(h),P(N(t+h)=n|N(t)=n)=1-λh+o(h),h↘0. |
| (6.3) |
Jest to o tyle ważne, że w podobnym języku łatwo formułować założenia o ogólniejszych
procesach, na przykład tak zwanych procesach urodzin i śmierci. Wrócimy do tego przy okazji omawiania łańcuchów Markowa.
6.2.2. Niejednorodne procesy Poissona w przestrzeni
Naturalne uogólnienia procesu Poissona polegają na tym, że
rozważa się losowe zbiory punktów w przestrzeni o dowolnym wymiarze i
dopuszcza się różną intensywność pojawiania się punktów w różnych rejonach
przestrzeni. Niech X będzie przestrzenią polską. Czytelnik, który nie
lubi abstrakcji może założyć, że X⊆Rd.
Musimy najpierw wprowadzić odpowiednie oznaczenia. Rozważmy ciąg wektorów
losowych w X:
(może to być ciag skonczony lub nie, liczba tych wektorów może być
zmienną losową). Niech, dla A⊆X,
oznacza liczbę wektorów, które ,,wpadły do zbioru A” (przy tym dopuszczamy wartość NA=∞ i umawiamy się liczyć powtarzające się wektory tyle razy, ile razy występują w ciągu).
Niech teraz μ będzie miarą na (σ-ciele borelowskich podzbiorów)
przestrzeni X.
Definicja 6.4
N(⋅) jest procesem Poissona z miara intensywnosci μ, jesli
-
dla parami rozłącznych zbiorów A1,…,Ai⊆X,
odpowiadające im zmienne losowe NA1,…,NAi są niezależne;
-
PNA=n=e-μAμAnn!, dla
każdego A⊆X takiego, że μA<∞ i dla n=0,1,….
Z elementarnych własności rozkładu Poissona wynika następujący wniosek.
Wniosek 6.1
Rozważymy rozbicie zbioru A o skończonej mierze intensywności, μA<∞, na rozłączną sumę A=A1∪⋯∪Ak. Wtedy
|
P(N(A1)=n1,…,N(Ak)=nk|N(A)=n)=n!n1!⋯nk!μ(A1)n1⋯μ(Ak)nk,(n1+⋯+nk=n). |
|
Jeśli natomiast μA=∞ to łatwo zauważyć, że NA=∞ z prawdopodobieństwem 1.
Z Definicji 6.4 i Wniosku 6.1 natychmiast wynika następujący algorytm generowania procesu Poissona. Załóżmy, że interesuje nas ,,fragment” procesu w zbiorze A⊆X o skończonej mierze intensywności. W praktyce zawsze symulacje muszą się
do takiego fragmentu ograniczać. Zauważmy, że unormowana miara μ(⋅)/μ(A) jest rozkładem prawdopodobieństwa (zmienna losowa X ma
ten rozkład, jeśli PX∈B=μB/μA, dla B⊆A).
| Gen N∼PoissμA |
| for i=1 to N do Gen Xi∼μ(⋅)/μ(A) |
Należy rozumieć, że formalnie definiujemy NB=#i:Xi∈B dla B⊆A, w istocie jednak za realizację procesu uważamy zbiór punktów X1,…,XN⊂A
(,,zapominamy” o uporządkowaniu punktów). Widać, że to jest proste uogólnienie analogicznego
algorytmu dla ,,zwykłego” procesu Poissona, podanego wcześniej.
Można również rozbić zbiór A na rozłączną sumę A=A1∪⋯∪Ak i generować
niezależnie fragmenty procesu w każdej części Aj.
Przykład 6.1
Jednorodny proces Poissona na kole B2={x2+y2⩽1} można wygenerować w następujący sposób. Powiedzmy, że intensywność (punktów na jednostkę pola) jest λ, to znaczy
μB=λB, gdzie B jest polem (miarą Lebesgue'a) zbioru B.
Najpierw generujemy N∼Poissλπ, następnie punkty X1,Y1,…,XN,YN niezależnie z rozkładu UB2. To wszystko.
Ciekawszy jest następny przykład.
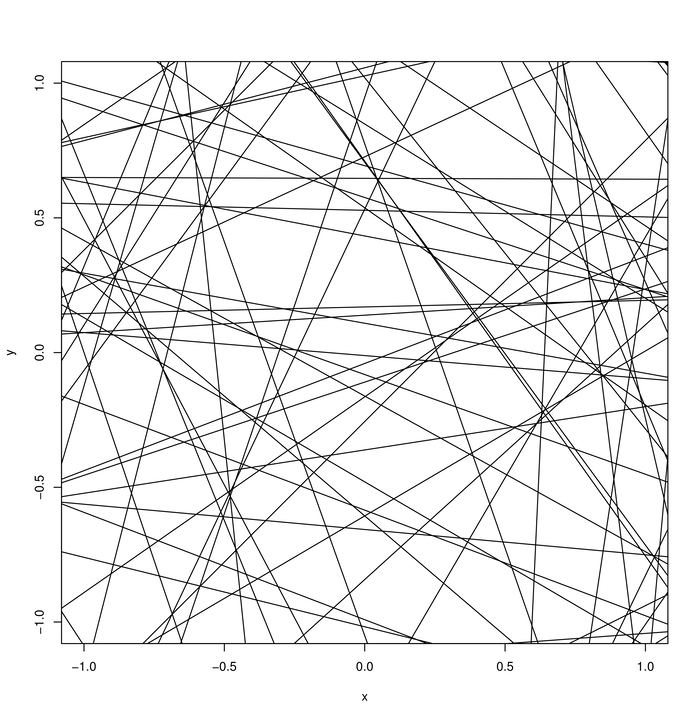
Przykład 6.2 (Jednorodny proces Poissona w przestrzeni prostych)
Prostą na płaszczyźnie można sparametryzować
podając kąt φ∈[0,2π[ jako tworzy prostopadła do prostej z osią poziomą oraz odległość r≥0 prostej od początku układu. Każda prosta jest więc opisana przez parę liczb
φ,r czyli punkt przestrzeni L=[0,2π[×[0,∞[. Jeśli teraz
wygenerujemy jednorodny proces Poissona na tej przestrzeni, to znaczy proces o intensywności
μB=λB, B⊆L, to można się spodziewać zbioru ,,losowo położonych
prostych”. To widać na Rysunku 6.1.
W istocie, wybór parametryzacji zapewnia, że rozkład prawdopodobieństwa procesu nie zależy
od wyboru układu współrzędnych. Dowód, czy nawet precyzyjne sformułowanie tego stwierdzenia przekracza ramy tego skryptu. Intuicyjnie chodzi o to, że na obrazku ,,nie ma wyróżnionego kierunku ani wyróżnionego punktu”.
Nie można sensownie zdefiniować pojęcia ,,losowej prostej” ale każdy przyzna, że proces Poissona o którym mowa można uznać za uściślenie intuicyjnie rozumianego pojęcia
,,losowego zbioru prostych”.
Ciekawe, że podstawowe metody generowania zmiennych losowych mają swoje odpowiedniki dla
procesów Poissona. Rolę rozkładu prawdopodobieństwa przejnuje miara intensywności.
Przykład 6.3 (Odwracanie dystrybuanty)
Dla miary intensywności λ
na przestrzeni jednowymiarowej można zdefiniować dystrybuantę tej miary.
Dla uproszczenia rozważmy przestrzeń X=[0,∞[ i założymy, że każdy zbiór ograniczony ma
miarę skończoną.
Niech Λt=λ0,t. Funkcję Λ:[0,∞[→[0,∞[ nazwiemy dystrybuantą. Jest ona niemalejąca, prawostronnie ciągła, ale granica w nieskończoności
Λ∞=limx→∞Λx może być dowolnym elementem z 0,∞.
Dla procesu Poissona na [0,∞[ wygodnie wrócić do prostszych oznaczeń, pisząc Nt=N0,t jak we wcześniej rozpatrywanym przypadku jednorodnym.
Niech Jt będzie jednorodnym procesem Poissona na [0,∞[ z intensywnoscia równą 1.
Wtedy
jest niejednorodnym procesem Poissona z miarą intensywności λ. W istocie,
jeśli 0<t1<t2<⋯ to Nt1,Nt2-Nt1,… są niezależne i maja
rozkłady odpowiednio PoissΛt1,PoissΛt2-Λt1,….
Zauważmy, że jeśli R1<R2<⋯ oznaczają punkty skoku procesu J(⋅) to
Nt=maxk:Rk⩽Λt=maxk:Λ-Rk⩽t,
gdzie Λ- jest uogólnioną funkcją odwrotną do dystrybuanty. Wobec tego
punktami skoku procesu N są Tk=Λ-Rk. Algorytm jest taki:
| Gen N∼PoissΛt; |
| for i:=1 to N do Gen Ri∼U0,Λt;Ti:=Λ-Ri |
Pominęliśmy tu sortowanie skoków i założyliśmy, że symulacje ograniczamy do odcinka 0,t.
Przykład 6.4 (Przerzedzanie)
To jest odpowiednik metody eliminacji. Załóżmy, że
mamy dwie miary intensywności: μ o gęstości m i λ o gęstości l.
To znaczy, że λB=∫Blxdx i μB=∫Bmxdx
dla dowolnego zbioru B⊆X. Załóżmy, że lx⩽mx i
przypuśćmy, że umiemy generować proces Poissona o intensywności μ. Niech
X1,…,XN będą punktami tego procesu w zborze A o skończonej mierze μ
(wiemy, że N∼Poiss(μ(A)). Punkt Xi akceptujemy z prawdopodobieństwem
lXi/mXi (pozostawiamy w zbiorze) lub odrzucamy (usuwamy ze zbioru) z prawdopodobieństwem
1-lXi/mXi. Liczba pozostawionych punktów L ma rozkład PoissλA, zaś każdy z
tych punktów ma rozkład o gęstości lx/λA, gdzie λA=∫Alxdx.
Te punkty tworzą proces Poissona z miarą intensywności λ.
| Gen X={X1,…,XN}∼Poiss(μ(⋅)); |
| for i:=1 to N Gen Ui∼U0,1; |
| if Ui>lXi/mXi then X:=X∖Xi; |
| return X={X1′,…,XL′}∼Poiss(λ(⋅)) |
Przykład 6.5 (Superpozycja)
To jest z kolei odpowiednik metody kompozycji.
Metoda opiera się na następującym prostym fakcie. Jezeli
N1(⋅),…,Nk(⋅) są niezależnymi procesami Poissona z miarami intensywnosci
odpowiednio μ1(⋅),…,μk(⋅), to N(⋅)=∑iNi(⋅) jest procesem Poissona z intensywnością μ(⋅)=∑iμi(⋅). Dodawanie należy tu rozumieć w dosłaowny sposób, to znaczy NA jest określone jako ∑iNiA dla każdego zbioru
A. Jeśli utożsamimy procesy z losowymi zbiorami punktów to odpowiada temu operacja brania sumy mnogościowej (złączenia zbiorów). Niech
Xj,1,…,Xj,Nj będą punktami j-tego procesu w zborze A o skończonej mierze
μj.
| X=∅; |
| for j:=1 to k do |
| begin |
| Gen Xj={Xj,1,…,Xj,Nj}∼Poiss(μj(⋅)); |
| X:=X∪Xj; |
| end |
| return X={X1′,…,XN′}∼Poiss(μ(⋅)) |
| { mamy tu N=∑jNj } |
Wygodnie jest utożsamiać procesy Poissona z losowymi zbiorami punktów, jak uczyniliśmy w ostatnich przykładach (i mniej jawnie w wielu miejscach wcześniej). Te zbiory można rozumieć
w zwykłym sensie, dodawać, odejmować tak jak w teorii mnogości pod warunkiem, że ich elementy
się nie powtarzają. W praktyce mamy najczęściej do czynienia z intensywnościami, które mają gęstości ,,w zwykłym sensie”, czyli względem miary Lebesgue'a. Wtedy, z prawdopodobieństwem 1, punkty procesu Poissona nie powtarzają się.