Zagadnienia

3. Analiza Składowych Głównych

3.1. Analiza danych wielowymiarowych

Oznaczenia:

  • X będzie oznaczał wektor losowy w przestrzeni Rp: X=X1…Xp.

  • Przez t oznaczymy wektor liczb, t∈Rp.

  • C to macierz liczb: C∈Rr×p.

  • Σ będzie oznaczać macierz kowariancji wektora losowego X, czyli:

    Σ=E⁢Xi-E⁢Xi⁢Xj-E⁢Xji,j=1p.

    Oznaczeń Σ=Var⁢X=Cov⁢X będziemy używać zamiennie.

Stwierdzenie 3.1

Proste własności wprowadzonych pojęć:

  1. E⁢tT⁢X=tT⁢E⁢X, E⁢XT⁢t=E⁢XT⁢t.

  2. E⁢C⁢X=C⁢ ⁢E⁢X, gdzie:

    C=C1T…CrT,⁢E⁢C⁢X=1C1T…CrT⁢E⁢X

    .

  3. Macierz kowariancji jest równa:

    Σ=E⁢X-E⁢X⁢X-E⁢XT.
  4. Macierz kowariancji ma następującą własność:

    Var⁢C⁢X=E⁢C⁢X-E⁢C⁢X⁢C⁢X-E⁢C⁢XT=
    =E⁢C⁢X-E⁢X⁢X-E⁢XT⁢CT=
    =C⁢ ⁢E⁢X-E⁢X⁢X-E⁢XT⁢CT=
    =C⁢Var⁢X⁢CT.
  5. Ponadto, macierz Var⁢X jest symetryczna i nieujemnie określona:

    symetryczność wynika z symetryczności kowariancji dwóch zmiennych losowych;

    nieujemna określoność wynika z nieujemności wariancji dla zmiennej losowej. Dla CT o wymiarach 1×p:

    0≤Var⁢CT⁢X︸zm losowa=4CT⁢Var⁢X⁢C=CT⁢Σ⁢C.
  6. Jeżeli Var⁢X=σ2⁢Ip, a macierz C jest ortonormlna o wymiarach p×p (CT⁢C=C⁢CT=Ip), to:

    Var⁢C⁢X=C⁢Var⁢X⁢CT=σ2⁢C⁢CT=σ2⁢Ip⁢ , czyli się nie zmienia.

3.2. Redukcja Wymiaru danych

Wygodną postacią macierzy wariancji Σ=Var⁢X jest postać diagonalna. Wtedy korelacje pomiędzy różnymi elementami wektora losowego są zerowe.

Problem 3.1

Jak przekształcić wektor losowy X żeby zdiagonalizować Σ?

Twierdzenie 3.1

Rozkład spektralny macierzy symetrycznej A. Dla symetrycznej macierzy A o wymiarze p×p istnieją:

  • ortonormalna (czyli V⁢VT=Ip) macierz kwadratowa V o wymiarze p×p, oznaczmy V=v1,…,vp;

  • diagonalna macierz Λ o wyrazach na przekątnych λ1,…,λp, że

A⁢vi=λi⁢vi⁢ , czyli 

vi to wektory własne macierzy A, a λi to wartości własne, które dla macierzy symetrycznej są rzeczywiste. Wtedy:

A⁢v1,…,vp=λ1⁢v1,…,λp⁢vp;
A⁢V=V⁢Λ;
A=V⁢Λ⁢VT;
Λ=VT⁢A⁢V.

Ponieważ macierz kowariancji Σ wektora losowego X jest symetryczna, możemy zastosować do niej rozkład spektralny: Σ=V⁢Λ⁢VT. Pomnóżmy wektor X przez macierz VT: VT⁢X. Macierz kowariancji dla takiego wektora to:

Var⁢VT⁢X=VT⁢Var⁢X⁢V=VT⁢Σ⁢X⁢V=Λ.

Ponieważ macierz Σ jest nieujemnie określona, wszystkie jej wartości własne są nieujemne: λi≥0. Uporządkujmy wartości własne λi i odpowiadające im wektory własne vi tak, żeby λ1≥λ2≥…≥λp≥0. Oznaczmy dla tak ustawionych wektorów własnych:

Y=VT⁢X.

3.2.1. Analiza składowych głównych – wersja populacyjna

Definicja 3.1

Mamy wektor losowy X∈Rp oraz macierz kowariancji Var⁢X=Σ=V⁢Λ⁢VT.

Składowymi głównymi (principal components) nazywamy elementy wektora Y1,…,YpT=Y=VT⁢X.

Kierunkami głównymi (rotations) nazywamy kolumny macierzy V=v1,…,vp.

Stwierdzenie 3.2

Własności składowych głównych:

  • wsółrzędne wektora Y są nieskorelowane;

  • wariancje poszczególnych Yi równe są λi;

  • Yi ustawione są od 1 do p w kolejności nierosnących wariancji;

  • Yi to kombinacje liniowe zmiennych losowych X1,…,Xp;

Stwierdzenie 3.3

Kierunki główne to unormowane wektory, w kierunku których obserwujemy największą wariancję danych, będące wzajemnie do siebie prostopadłe:

  1. jeżeli t1∈Rp, t1T⁢t1=1 ⇒ Var⁢t1T⁢X osiąga maksimum=λ1 dla t1=v1.

  2. jeżeli t2∈Rp, t2T⁢t2=1, t2T⁢t1=0 ⇒ Var⁢t2T⁢X osiąga maksimum=λ2 dla t2=v2.

V=v1,…,vp jest bazą ortonormalną przestrzeni Rp.

  1. Zapiszmy t1 w tej bazie: t1=∑i=1pci⁢vi, gdzie ci∈R współczynniki. Z założeń wynika:

    t1T⁢t1=∑i=1pci2=1.

    Zauważmy, że:

    Var⁢t1T⁢X=t1T⁢Var⁢X⁢t1=c1⁢v1T+…+cp⁢vpT⋅Σ⋅c1⁢v1+…+cp⁢vp=

    z własności wektorów własnych macierzy,

    =(c1v1T+…+cpvpT)⋅(λ1c1v1+…+λpcpvp)=∑i=1pλici2≤λ1.

    Jeżeli przyjmiemy t1=v1, czyli c1=1, c≥2=0, otrzymujemy kombinację liniową o maksymalnej wariancji równej λ1.

  2. Ponieważ t2T⁢v1=0, możemy zapisać:

    Var⁢t2T⁢X=t2T⁢Var⁢X⁢t2=c2⁢v2T+…+cp⁢vpT⋅Σ⋅c2⁢v2+…+cp⁢vp=
    =∑i=2pλici2≤λ2.

    Analogicznie, t2=v2.

∎
Stwierdzenie 3.4

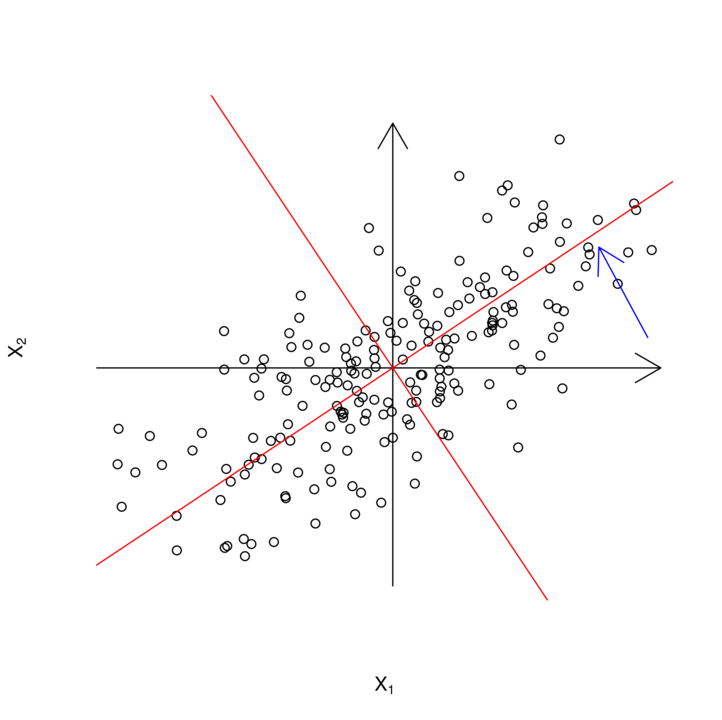
Ponieważ V jest macierzą ortonormalną, możemy interpretować VT⁢X jako współrzędne dla obróconego układu. Dla p=2 obrócone osie byłyby wyznaczone przez v1 i v2, przy czym v1 byłby kierunkiem, w którym mamy największą zmienność danych, a v2 prostopadłym do niego (rysunek 3.1).

\par
Rys. 3.1. Kierunki główne wyznaczją obrócone osie układu współrzędnych.
Definicja 3.2

Całkowity rozrzut danych dla wektora losowego X to suma wariancji jego współrzędnych: ∑i=1pVar⁢Xi. Wariancje poszczególnych Xi można interpretować jako ilość informacji, jaką przechowuje dana zmienna: im większa wariancja, tym lepiej możemy różnicować obserwowane wielkości.

Uwaga 3.1

Ślady macierzy Σ i Λ równają się sobie, czyli całkowite rozrzuty danych dla X i Y są równe:

∑i=1pλi=tr⁢Λ=tr⁢VT⁢Σ⁢V=tr⁢VT⁢V⁢Σ=tr⁢Σ

.

Istotnym parametrem diagnostycznym przy rozważaniu analizy składowych głównych jest:

λ1+…+λkλ1+…+λp,

czyli część całkowitego rozrzutu danych wyjaśniona przez k pierwszych składowych głównych. Na jego podstawie dokonuje się redukcji wymiaru danych: z p zmiennych zostaje utworzone k kombinacji liniowych tych zmiennych, które wyjaśniają np. 90⁢% zmienności wyjściowych danych.

3.2.2. Analiza składowych głównych – wersja próbkowa

Podejście próbkowe do analizy danych różni się od populacyjnego tym, że w podejściu populacyjnym do analizy brana jest zmienna losowa, a w podejściu próbkowym jej realizacje. Dlatego teraz zamiast wektora zmiennych losowych X będziemy rozpatrywać macierz jego n realizacji:

X=X11…X1⁢pX21…X2⁢p…Xn⁢1…Xn⁢p⁢=⁢X1TX2T…XnT.

Do analizy potrzebna będzie macierz kowariancji próbkowej. Zdefiniujmy scentrowaną macierz X jako:

Xc=X11-X¯.1…X1⁢p-X¯.pX21-X¯.1…X2⁢p-X¯.p…Xn⁢1-X¯.1…Xn⁢p-X¯.p⁢=⁢Xc⁢1TXc⁢2T…Xc⁢nT,

gdzie X¯.i=1n⁢∑j=1nXj⁢i, i=1,…,p.

Zauważmy, że macierz kowariancji próbkowej możemy wyrazić za pomocą macierzy:

S=var⁢X=1n-1⁢XcT⁢Xc=1n-1⁢∑i=1nXc⁢i⁢Xc⁢iT,

która jest nieobciążonym estymatorem macierzy kowariancji:

Σ=E⁢X-E⁢X⁢X-E⁢XT.

Macierz S jest symetryczna i nieujemnie określona. Znajdźmy składowe główne dla podejścia próbkowego tą samą metodą jak dla podejścia populacyjnego:

VT⁢S⁢V=Λ=1n-1⁢VT⁢XcT⁢Xc⁢V=1n-1⁢Xc⁢VT⁢Xc⁢V=1n-1⁢YT⁢Y.
Wniosek 3.1

Składowe główne dla problemu próbkowego równe są wektorom Y1,…,Yp=Y=Xc⁢V, macierz kowariancji próbkowej dla Y jest równa Λ.

3.2.3. Rozkład na wartości szczególne (Singular Value Decomposition)

Rozkład SVD posłuży nam do tańszej obliczeniowo konstrukcji składowych głównych w wersji próbkowej.

Twierdzenie 3.2

Rozkład na wartości szczególne Dla dowolnej macierzy A∈Rm×n m≥n, ∃ U macierz ortonormalna ∈Rm×n oraz V macierz ortonormalna ∈Rn×n takie, że A=U⁢Σ⁢VT, gdzie Σ∈Rm×n jest macierzą diagonalną:

Σ=Σ′000⁢,⁢Σ′=diag⁢σi⁢ ∈Rk×k,
σ1≥…≥σk>σk+1=…=σn=0,

gdzie k jest rzędem macierzy A. Rozkład taki nazywamy szerokim rozkładem SVD, w odróżnieniu od wąskiego rozkładu SVD, w którym skracamy macierze do istotnych obliczeniowo:

Am×n=Um×m⁢Σm×n⁢Vn×nT=
=(|U1m×k|U2m×m-k|)(Σ′000)(V1n×kTV2n×n-kT)=
=U1⁢Σ′⁢V1T.

Zauważmy, że macierz AT⁢A jest symetryczna i nieujemnie określona:

∀t∈Rn⁢⁢tT⁢AT⁢A⁢t=A⁢tt⁢A⁢t≥0.

Zatem, korzystając z rozkładu spektralnego dla AT⁢A otrzymujemy:

VT⁢AT⁢A⁢V=diag⁢λi=diag⁢σ12,…,σn2, (3.1)

gdzie założymy, że σi to nieujemne pierwiastki z λi:

σ1≥…≥σk>σk+1=…=σn=0.

Zauważmy, że V1T⁢AT⁢A⁢V1 jest podmacierzą VT⁢AT⁢A⁢V o niezerowych wyrazach na przekątnej:

V1T⁢AT⁢A⁢V1=σ120…0σk2

Zdefiniujmy U1 jako:

U1=A⁢V1⁢ diag⁢σ1-1,…,σk-1,

skąd otrzymujemy:

U1⁢ diag⁢σ1,…,σk=A⁢V1.
U1T⁢U1=σ1-10…0σk-1⁢V1T⁢AT⁢A⁢V1︸diag⁢σ12,…,σk2⁢σ1-10…0σk-1=Ik.

Uzupełniamy dowolnie U1 do ortonormalnej macierzy n×n : U=U1|U2. Wtedy:

UT⁢A⁢V=U1TU2T⁢A⁢V1|V2=U1T⁢A⁢V1U1T⁢A⁢V2U2T⁢A⁢V1U2T⁢A⁢V2=

ponieważ ze wzoru (3.1) wynika, że ∀ i takiego, że vi∈V2, viT⁢AT⁢A⁢vi=A⁢viT⁢A⁢vi=σi2=0, a norma euklidesowa wektora jest równa zero wtedy i tylko wtedy gdy wektor jest równy zero, otrzymujemy:

=(diag⁢σ1-1,…,σk-1⁢V1T⁢AT⁢A⁢V1︸=diag⁢σ12,…,σk2|0U2T⁢U1⁢ diag⁢σ1,…,σk|0)=
=(diag⁢σ1,…,σk|0k×n-k0m-k×k|0m-k×n-k)=Σ.

Z równości UT⁢A⁢V=Σ, ponieważ U i V są macierzami ortonormalnymi, wynika:

A=U⁢Σ⁢VT=U1⁢Σ′⁢V1T.
∎
Stwierdzenie 3.5

Wróćmy do analizy składowych głównych. Do scentrowanej macierzy danych Xc o wymiarze n×p użyjmy wąskiego rozkładu SVD i oznaczmy:

Xc=U⁢Λ⁢VT;

wtedy:

var⁢Xc=S=1n-1⁢XcT⁢Xc=1n-1⁢V⁢ΛT⁢UT⁢U︸=Ip⁢Λ⁢VT=
=1n-1VΛ2VT=VDVT.
Wniosek 3.2

Zauważmy, że:

  1. Składowe główne w wersji próbkowej przy użyciu rozkładu SVD:

    Y=Xc⁢V=U⁢Λ⁢VT⁢V=U⁢Λ=λ1⁢U1,…,λp⁢Up.

    Obliczanie składowych głównych z tego wzoru jest tańsze obliczeniowo.

  2. Widać związek pomiędzy rozkładem SVD dla X=U⁢Σ⁢VT oraz rozkładem spektralnym dla XT⁢X=V⁢Σ2⁢VT.

  3. Podobnie jest dla X⁢XT=U⁢Σ⁢VT⁢V︸=I⁢Σ⁢UT=U⁢Σ2⁢UT.

3.2.4. Kolejna zaleta analizy składowych głównych

Wróćmy do analizy składowych głównych w wersji populacyjnej.

Stwierdzenie 3.6

Przy założeniu, że wektor losowy X∈Rp jest scentrowany E⁢X=0, możemy zapisać Var⁢X=E⁢X⁢XT. Korzystając z rozkładu spektralnego, oznaczmy Var⁢X=Σ=V⁢Λ⁢VT. Wtedy:

∀⁢k≤p⁢⁢układ ⁢v1,…,vk⁢⁢minimalizuje⁢⁢E⁢X-∑i=1kXT⁢ai⁢ai2
wśród wszystkich układów ortonormalnych a1,…,ak.

Czyli w sensie minimalizacji błędu średniokwadratowego najlepszym k-wymiarowym przybliżeniem X jest rzut ortogonalny X na k pierwszych kierunków głównych.

E⁢X-∑jXT⁢aj⁢ajT⁢X-∑iXT⁢ai⁢ai=
=EXTX-E∑i(XTai)(aiTX)-E∑i(XTai)(XTai)+E⁢XT⁢aj⁢ajT⁢∑iXT⁢ai⁢ai︸a1,…,ak⁢są ortonormalne=
=EXTX-E∑i(XTai)2-E∑i(XTai)2+E∑j(XTaj)2=
=EXTX-E∑j=1k(XTaj)2.To wyrażenie chcemy zminimalizować.

Czyli maksymalizujemy po a1,…,ak:

E⁢∑j=1kXT⁢aj2=∑j=1kajT⁢E⁢X⁢XT⁢aj=
=∑j=1kajT[∑i=1pλiviviT]aj=∑j=1k∑i=1pλi(viTaj)2=♣

Przyjrzyjmy się współczynnikom przy λi, są to kwadraty współczynników aj w bazie ortonormalnej vi, więc sumują się do jedynki:

a1T⁢v12⁢+⁢a1T⁢v22⁢+…+⁢a1T⁢vp2⁢=1
⁢⁢+⁢⁢⁢⁢⁢⁢⁢⁢⁢⁢⁢+⁢⁢⁢⁢⁢⁢⁢⁢⁢⁢⁢⁢⁢⁢⁢⁢⁢⁢⁢+
a2T⁢v12⁢+⁢a2T⁢v22⁢+…+⁢a2T⁢vp2⁢=1
 ⁢⁢…
⁢⁢+⁢⁢⁢⁢⁢⁢⁢⁢⁢⁢⁢+⁢⁢⁢⁢⁢⁢⁢⁢⁢⁢⁢⁢⁢⁢⁢⁢⁢⁢⁢+
akT⁢v12︸=h1⁢+⁢akT⁢v22︸=h2⁢+…+⁢akT⁢vp2︸=hp⁢=1
 ⁢⁢…
⁢⁢+⁢⁢⁢⁢⁢⁢⁢⁢⁢⁢⁢+⁢⁢⁢⁢⁢⁢⁢⁢⁢⁢⁢⁢⁢⁢⁢⁢⁢⁢⁢+
apT⁢v12︸=1⁢+⁢apT⁢v22︸=1⁢+…+⁢apT⁢vp2︸=1⁢=1
w każdej kolumnie można uzupełnić do bazy, wtedy suma=1;

Czyli otrzymujemy:

∀i=1,…,p⁢⁢hi≤1; jednocześnie ⁢∑i=1khi=k;
♣=∑i=1pλi⁢hi≤λ1+λ2+…⁢λk.

Jeśli podstawimy a1=v1,a2=v2,…,ak=vk, otrzymujemy h1=1,…,hk=1,hk+1=0,…,hp=0, dla których osiągane jest wyliczone maksimum.

∎

3.3. Przykłady w programie R

Treść automatycznie generowana z plików źródłowych LaTeXa za pomocą oprogramowania wykorzystującego LaTeXML.

Projekt współfinansowany przez Unię Europejską w ramach Europejskiego Funduszu Społecznego.

Projekt współfinansowany przez Ministerstwo Nauki i Szkolnictwa Wyższego i przez Uniwersytet Warszawski.