Zagadnienia

8. Modele liniowe

8.1. Predykcja cechy ciągłej

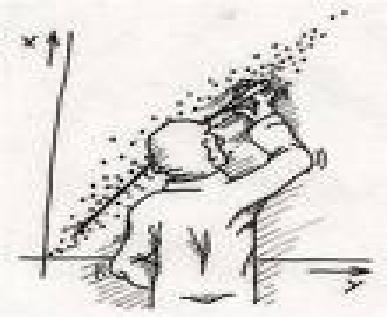
Będziemy obserwować ciągłą zmienną objaśnianą yi oraz zmienne objaśniające xi=xi⁢1,…,xi⁢p, i=1,…,n. Na ich podstawie będziemy chcieli znaleźć funkcję zależącą od x, która będzie najlepiej przybliżać cechę y. Ograniczymy się przy tym tylko do zależności liniowej. Na podstawie znalezionej funkcji, dla nowo zaobserwoawanych xn+1 będziemy mogli znależć predykcję y^n+1. Jeżeli rozpatrzymy jednowymiarowy xi (p=1), szukanie funkcji liniowej najlepiej przybliżającej dane obrazuje rysunek 8.1.
\par
Rys. 8.1. Regresja liniowa jako dopasowanie prostej do danych.

Dane są postaci:

y1…yn︸losowe,obserwowane=x11…x1⁢p………xn⁢1…xn⁢p︸deterministyczne,obserwowane⋅β1…βp︸szukane+ε1…εn︸losowe,nieobserwowane.

W zapisie macierzowym:

y=X⁢β+ε,

gdzie:

  • wektor y będziemy nazywać zmienną objaśnianą;

  • macierz X macierzą planu;

  • β estymowanymi parametrami;

  • ε to wektor efektów losowych (wektor realizacji zmiennej losowej).

Dla tak sformułowanego problemu przyjmiemy następujące założenia:

  1. E⁢ε=0;

  2. Var⁢ε=σ2⁢In;

  3. rząd macierzy X jest pełny: rank⁢X=p.

Dla tak sformułowanych danych, problem szukania estymatora parametru β będziemy nazywać problemem liniowym.

Twierdzenie 8.1

Rozkład QR macierzy

Szeroki rozkład QR: Każdą rzeczywistą macierz A wymiaru n×m m≤n można zapisać jako iloczyn maierzy ortogonalnej Q wymiaru n×n QT⁢Q=In oraz górnotrójkątnej macierzy R wymiaru n×m:

A=Q⁢R=Q⁢∘∘∘.

Wąski rozkład QR: Ponieważ n-m dolnych wierzy macierzy R jest zerowa, można skrócić zapis do

A=Q⁢R=Q⁢R0=Q1⁢⁢Q2⋅R10=Q1⁢R1=,
=Q1⁢∘∘∘.

gdzie Q1 jest macierzą wymairu n×m o ortogonalnych kolumnach a R1 jest macierzą górnotrójkątną wymairu m×m.

Wąski rozkład QR jest zapisem macierzowym ortogonalizacji Gramma-Schmidta układu wektorów będących kolumnami macierzy A. Szeroki rozkład otrzymujemy dopełniając macierz Q1 do bazy przestrzeni Rn.

∎
Problem 8.1

Przy założeniu modelu liniowego, będziemy chcieli wyestymować nieznane parametry: β i σ2.

8.2. Metoda najmniejszych kwadratów (mnk)

Zauważmy, że

E⁢y=E⁢X⁢β+ε=X⁢β+E⁢ε=X⁢β.

Estymator najmnieszych kwadratów parametru β to taka jego wartość, dla której odległości euklidesowe przybliżanych danych od prostej je przybliżających jest najmniejsza:

β^=minβ⁡y-X⁢β2.
Twierdzenie 8.2

Estymator najmniejszych kwadratów wyraża się wzorem

β^=R1-1⁢Q1T⁢y,

gdzie R1 i Q1 pochodzą z wąskiego rozkładu QR macierzy planu X.

Skorzystajmy z szerokiego rozkładu QR macierzy X: X=Q⁢R. Ponieważ mnożenie wektora przez macierz ortogonalną nie zmienia jego normy, możemy zapisać:

y-X⁢β2=QT⁢y-Q⁢R⁢β2=
=||Q1T(y-Q1R1β)||2+||Q2T(y-Q1R1β)||2=
=Q1T⁢y-R1⁢β2+Q2T⁢y2.

Wyrażenie to osiąga minimum ze względu na parametr β, jeżeli wyzerujemy pierwszy składnik sumy:

Q1T⁢y=R1⁢β^.

Ponieważ macierz R1 jest kwadratowa i pełnego rzędu (rankX=p), możemy ją odwrócić:

β^=R1-1⁢Q1T⁢y.
∎
Wniosek 8.1

Zauważmy, że:

  1. Predykcja dla y jest równa y^=X⁢β^;

  2. y-y^2=Q2T⁢y2. (8.1)

Przyjrzyjmy się własnościom metody najmniejszych kwadratów (zostaną one udowodnione w dalszej części wykładu):

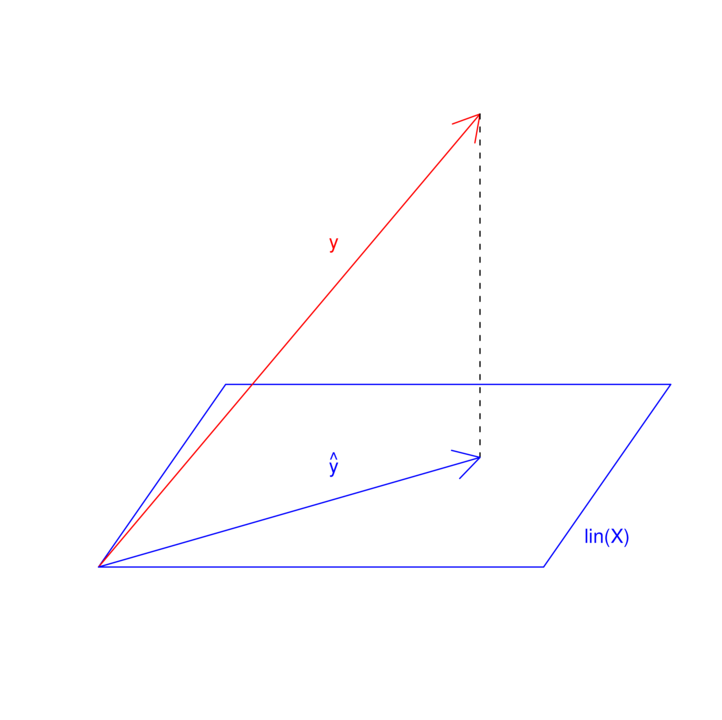
  1. y^=X⁢β^ jest rzutem ortogonalnym y na przestrzeń rozpiętą przez kolumny macierzy planu X.

  2. Nieobciążonym estymatorem parametru σ2 jest σ^2=y-y^2n-p.

  3. Twierdzenie Gaussa-Markowa: estymator β^ jest liniowym, nieobciążonym estymatorem o najmniejszej wariancji parametru β (BLUE- Best Linear Unbiased Estimator).

  4. Przy założeniu ε∼N⁢0,σ2⁢In, zachodzi twierdzenie Fishera:

    • β^∼N⁢β,σ2⁢XT⁢X-1;

    • n-p⁢σ^2σ2∼χ2⁢n-p;

    • β^ i σ^2 są niezależne.

8.3. Inne wyprowadzenie estymatora najmniejszych kwadratów

Wyprowadzimy estymator mnk jako rozwiązanie zadania BLUE – liniowy, nieobciążony estymator o najmniejszej wariancji. Rozumowanie będzie jednocześnie dowodem twierdzenia Gaussa-Markowa.

Twierdzenie 8.3

Dla problemu liniowego estymator postaci β^=XT⁢X-1⁢XT⁢y jest liniowym, nieobciążonym estymatorem o najmniejszej wariancji parametru β.

Żeby łatwiej mówić o nieobciążoności, czy minimalnej wariancji, zredukujemy wymiar problemu do jednowymiarowego zakładając, że własności będą zachodzić dla wszystkich możliwych kombinacji liniowych zmiennej objaśnianej: Dla danego wektora l, konstruujemy kombinację liniową μ=lT⁢β i szukamy dla niej estymatora zależącego liniowo od y:

μ^=cT⁢y

przy założeniu nieobciążoności:

E⁢μ^=μ=lT⁢β.

Jednocześnie wiemy, że:

E⁢μ^=cT⁢E⁢y=cT⁢X⁢β.

Stąd:

cT⁢X=lT.

Będziemy minimalizować wariancję estymatora μ^:

Var⁢μ^=Var⁢cT⁢y=cT⁢Var⁢y⁢c=σ2⁢cT⁢c.

Zadanie optymalizacyjne wygląda następująco:

minc⁡σ2⁢cT⁢c⁢ pod warunkiem ⁢cT⁢X=lT.

Skorzystajmy z metody mnożników Lagrange'a:

mincF⁢c,λ=σ2⁢cT⁢c+cT⁢X-lT⁢λ︸wektor.

Szukamy estymatora wektora c, spełniającego dwa równania:

∂⁡F∂⁡c=2⁢σ2⁢c+X⁢λ=0; (8.2)
∂⁡F∂⁡λ=XT⁢c-l=0. (8.3)

Z równania 8.2 otrzymujemy: c=-12⁢σ2⁢X⁢λ, wstawiamy do równania 8.3:

-12⁢σ2⁢XT⁢X=l,

skąd:

λ=-2⁢σ2⁢XT⁢X-1⁢l.

Macierz X jest pełnego rzędu, więc macierz XT⁢X jest odwracalna. Wstawiając λ do wzoru na c, otrzymujemy:

c=X⁢XT⁢X-1⁢l⁢ , inaczej: ⁢cT=lT⁢XT⁢X-1⁢XT.

Estymator μ^ jest więc postaci:

μ^=cT⁢y=lT⁢XT⁢X-1⁢XT⁢y;

podstawiając za l kolejne wektory bazy kanonicznej ei=0,…,0,1,0,…,0, znajdujemy kolejne estymatory kombinacji liniowych lT⁢β=eiT⁢β=βi^, co łącznie możemy zapisać jako:

β^=XT⁢X-1⁢XT⁢y.
∎
Stwierdzenie 8.1

Liniowy, nieobciążony estymator o najmniejszej wariancji parametru β w modelu liniowym jest równy estymatorowi najmniejszych kwadratów.

β⌃=XT⁢X-1⁢XT⁢y=

korzystając z wąskiego rozkładu QR: X=Q1⁢R1,

=(R1TQ1T⁢Q1︸=IpR1)-1R1TQ1Ty=
=R1-1R1T-1⁢R1T︸=IpQ1Ty=R1-1Q1Ty.
∎

8.4. Estymatory metody największej wiarygodności prametrów modelu liniowego

Estymatory największej wiarygodności to takie wartości parametrów, których prawdopodobieństwo zaobserwowania danych jest największe. Żeby skorzystać z tej metody estymacji, potrzebna jest funkcja wiarygodności, niezbędne więc będzie założenie na temat rozkładu danych:

Zamiast zakładać:

E⁢ε=0⁢,⁢Var⁢ε=σ2⁢In

założymy:

ε∼N⁢0,σ2⁢In,

skąd mamy y∼N⁢X⁢β,σ2⁢In oraz funkcję wiarygodności:

fβ,σ2⁢y1,…,yn=fβ,σ2⁢y=12⁢πn2⁢σ2⁢In12⁢exp⁡-12⁢y-X⁢β⁢σ-2⁢In⁢y-X⁢β=
=12⁢πn2⁢σ2n2⁢exp⁡-12⁢σ2⁢y-X⁢β2.

Funkcję wiarygodności będziemy chcieli zmaksymalizować po parametrach β i σ2. Ponieważ logarytm jest funkcją rosnącą, jest to równoważne z maksymalizacją logarytmu funkcji wiarygodności:

Fβ,σ2⁢y=log⁡fβ,σ2⁢y=C-n2⁢log⁡σ2-12⁢σ2⁢y-X⁢β2,

gdzie C jest stałą niezależną od szukanych parametrów. Zadanie maksymalizacji logwiarygodności Fβ,σ2 jest rónoważne minimalizacji -2⁢Fβ,σ2:

-2⁢Fβ,σ2⁢y=C′+n⁢log⁡σ2+1σ2⁢y-X⁢β2.

Część sumy zależąca od parametru β to 1σ2⁢y-X⁢β2. Wartością parametru β minimalizującą to wyrażenie jest:

β^m⁢n⁢w=XT⁢X-1⁢XT⁢y=R1-1⁢Q1T⁢y,

co udowodniliśmy już w twierdzeniu 8.2.

Ponieważ β^ nie zależy od parametru σ2, mogę wstawić estymator do funkcji wiarygodności przy szukaniu optymalnego parametru σ2. Oznaczmy także τ=σ2 żeby nie mylił się nam kwadrat przy parametrze:

-2⁢Fβ,σ2⁢y=C′+n⁢log⁡τ+1τ⁢y-X⁢β^2.
∂⁡-2⁢Fβ,σ2∂⁡τ=nτ-1τ2⁢y-X⁢β^2=0,

skąd otrymujemy:

n⁢τ=y-X⁢β^2;
τ^=σ^2=y-X⁢β^2n.
Wniosek 8.2

Przy założeniu rozkładu normalnego:

  1. estymatory parametru β dla metody największej wiarygodności i metody najmniejszych kwadratów są równe:

    β^m⁢n⁢k=β^m⁢n⁢w=XT⁢X-1⁢XT⁢y;
  2. estymatory parametru σ2 dla metody największej wiarygodności i metody najmniejszych kwadratów są równe z dokładnością do stałej:

    σ^m⁢n⁢k2=y-X⁢β^2n-p,⁢σ^m⁢n⁢w2=y-X⁢β^2n.

8.5. Kolejne własności estymatorów mnk

8.5.1. Wartość oczekiwana i wariancja estymatora β^

  • Wartość oczekiwana:

    E⁢β^=E⁢XT⁢X-1⁢XT⁢y=XT⁢X-1⁢XT⁢E⁢y=XT⁢X-1⁢XT⁢X⁢β=β. (8.4)

    Estymator jest niebciążony.

  • Macierz wariancji:

    Var⁢β^=E⁢β^-β⁢β^-βT=
    =E((XTX)-1XTy-(XTX)-1XTEy)((XTX)-1XTy-(XTX)-1XTEy)T=
    =(XTX)-1XTE[(y-Ey)(y-Ey)T]((XTX)-1XT)T=
    =(XTX)-1XTσ2In((XTX)-1XT)T=σ2(XTX)-1XT⁢X⁢XT⁢X-1︸=Ip=
    =σ2⁢XT⁢X-1. (8.5)

8.5.2. Dopasowanie y^ jako rzut ortogoanlny y na przestrzeń rozpiętą przez kolumny macierzy X

\par
Rys. 8.2. Dopasowanie y^ jako rzut ortogonalny y na lin⁢X.

Prypomnijmy

β^=XT⁢X-1⁢XT⁢y⁢,⁢y^=X⁢β^.
Definicja 8.1

Macierzą daszkową H nazwiemy taką macierz, że:

y^=X⁢XT⁢X-1⁢XT⁢y=H⁢y.

Stąd:

H=X⁢XT⁢X-1⁢XT.
Stwierdzenie 8.2

Zauważmy, że y^ jest nieobciążonym estymatorem y:

E⁢y^=X⁢XT⁢X-1⁢XT⁢X⁢β=X⁢β.
Stwierdzenie 8.3

Własności macierzy daszkowej H:

  1. H⁢X=X:

    X⁢XT⁢X-1⁢XT⁢X︸=Ip=X;
  2. macierz H jest idempotentna, czyli H⁢H=H:

    H⁢H=X⁢XT⁢X-1⁢XT⁢X︸=Ip⁢XT⁢X-1⁢XT=H;
  3. symetryczna, czyli HT=H:

    HT=X⁢XT⁢X-1⁢XTT=X⁢XT⁢X-1⁢XT=H.
  4. korzystając z wąskiego rozkładu QR macierzy X, H=Q1⁢Q1T:

    H=Q1⁢R1⁢R1T⁢Q1T⁢Q1︸=Ip⁢R1-1⁢R1T⁢Q1T⁢Q1︸=Ip⁢R1⁢R1-1︸=Ip⁢R1T-1⁢R1T︸=Ip⁢Q1T=
    =Q1R1⁢R1-1︸=IpR1T-1⁢R1T︸=IpQ1T=Q1Q1T.
  5. korzystając z szerokiego rozkładu QR macierzy X, możemy przyjrzeć się rozkładowi spektralnemu macierzy daszkowej:

    H=Q⁢R⁢RT⁢QT⁢Q︸=In⁢R-1⁢RT⁢QT=

    ponieważ RT⁢R=R1T⁢R1,

    =QR(R1TR1)-1RTQT=QRR1-1(R1T)-1RTQT=
    =Q⁢1…10⁢QT︸rozkład spektralny macierzy ⁢H=

    dla Q=q1,…,qp,…,qn:

    =Q1Q1T=∑i=1p1⋅qiqiT+∑i=p+1n0⋅qiqiT
Wniosek 8.3
  1. Macierz daszkowa H jest macierzą rzutu ortogonalnego na przestrzeń rozpiętą przez kolumny macierzy X.

  2. Jeżeli y^=X⁢β^ minimalizuje wyrażenie y-y^2, to jest rzutem ortogonalnym y na lin⁢X.

8.5.3. Nieobciążony estymator parametru σ2

Stwierdzenie 8.4

Macierz In-H jest macierzą rzutu ortogonalnego na przestrzeń prostopadłą do przestrzeni rozpiętej przez kolumny macierzy X, jest więc w szczególności symetryczna i idempotentna.

In-H=In-Q⁢Ip0⁢QT=
=QQT-Q(Ip0)QT=Q(0In-p)QT.
∎
Wniosek 8.4

Ponieważ ślad macierzy równy jest sumie jego wartości własnych, ślady macierzy daszkowej H i macierzy I-H to:

tr⁢H=p;
tr⁢I-H=n-p.
Stwierdzenie 8.5

Twierdzenie Pitgorasa w postaci macierzowej:

Var⁢y=Var⁢y^+Var⁢y-y^.
σ2⁢In=Var⁢H⁢y+Var⁢I-H⁢y;
σ2⁢In=H⁢Var⁢y⁢HT+I-H⁢Var⁢y⁢I-HT;

ponieważ macierze H i I-H są symetryczne i idempotentne, zachodzi:

σ2⁢In=σ2⁢H+σ2⁢In-H. (8.6)
∎
Stwierdzenie 8.6

Niebciążonym estymatorem parametru σ2 w modelu liniowym jest:

σ^2=y-y^2n-p.

Ponieważ y^ jest nieobciążonym estymatorem y, możemy zapisać:

E⁢y-y^2=∑i=1nVar⁢yi-y^i=tr⁢Var⁢y-y^=
=tr(σ2(I-H))=σ2(n-p).

Stąd:

E⁢y-y^2n-p=σ2.
∎

8.5.4. Model z większą liczbą parametrów nie musi być lepiej dopasowany dla nowych danych

  • Błąd predykcji y za pomocą y^ na tej samej próbie, korzystając ze wzoru 8.6, można zapisać w postaci:

    E⁢yi-y^i2=Var⁢yi-y^i=σ2⁢1-hi⁢i,

    gdzie hi⁢i jest elementem macierzy daszkowej: H=hi⁢ji,j=1n.

    Definicja 8.2

    Elementy przekątnej macierzy daszkowej H: hi⁢i będziemy nazywać ładunkami obserwsacji i-tej i oznaczać hi.

  • Dla nowych obserwacji mamy:

    Zakładamy niezależność nowych obserwacji zmiennej objaśnianej i p-wymiarowego wektora zmiennych objaśniających: yn+1,xn+1T od y,X. Będziemy estymować parametry używając danych treningowych y,X, a obliczać błąd dla nowych danych testowych:

    yn+1=xn+1T⁢β+εn+1;
    β^=XT⁢X-1⁢XT⁢y;
    y^n+1=xn+1T⁢β^.

    Błąd predykcji jest równy:

    E⁢yn+1-y^n+12=Var⁢yn+1-y^n+1⁢=︸z niezależności⁢Var⁢yn+1+Var⁢y^n+1=
    =σ2+Var(xn+1Tβ^)=σ2+xn+1TVar(β^)xn+1=
    =σ2+xn+1Tσ2(XTX)-1xn+1=σ2(1+hn+1),

    gdzie hn+1=xn+1T⁢XT⁢X-1⁢xn+1, analogicznie do ładunków obserwacji dla i=1,…,n: hi=xiT⁢XT⁢X-1⁢xi.

  • Porównanie obu błędów predykcji dla tej samej macierzy planu:

    Dane treningowe, dla których będziemy estymować parametr β^ to y,X gdzie y=y1,…,yn. Dane testowe, dla których będziemy liczyć błąd predykcji to w pierwszym przypadku ten sam zbiór y,X, a w drugim yt⁢e,X gdzie y=yn+1,…,y2⁢n są nowymi obserwacjami, a macierz planu X pozostaje niezmieniona. Porównajmy uśrednione oba błędy predykcji:

    E⁢1n⁢∑i=1nyi-y^i2=1n⁢E⁢y-y^2=n-p⁢σ2n;
    E⁢1n⁢∑i=n+12⁢nyi-y^i2=1n⁢∑i=n+12⁢nσ2⁢1+hi=n+p⁢σ2n,

    gdzie korzystamy z równości hn+i=hi, co zachodzi dzięki użyciu tej samej macierzy planu X w zbiorze treningowym i testowym oraz własnści macierzy daszkowej ∑i=1nhi=p.

    Wniosek 8.5

    Na podstawie obliczonych błędów predykcji możemy wywnioskować:

    1. Większy model nie zawsze oznacza lepsze dopasowanie.

    2. Różnica pomiędzy błędami predykcji wynosi:

      1n⁢E⁢y-y^2-1n⁢E⁢yt⁢r-y^2=2⁢p⁢σ2n

8.5.5. Kroswalidacja leave-one-out

Estymację błędu predykcji można oprzeć na kroswalidacji leave-one-out. Dla każdej obserwacji będziemy estymować model za pomocą wszystkich obserwacji oprócz niej samej i obliczać błąd predykcji na nowych danych dla tej pominiętej obserwacji. W ten sposób dostaniemy n błędów predykcji, które następnie uśrednimy.

Niech Xi, i=1,…,n oznacza macierz X z usuniętą i-tą obserwacją (i-tym wierszem), yi wektor obserwacji z usuniętą i-tą obserwacją. Estymator β^i będzie oznaczać estymator mnk na podstawie danych yi,Xi:

β^i=XiT⁢Xi-1⁢XiT⁢yi;

Predykcja dla pominiętej obserwacji wyraża się wzorem:

y^i=xiT⁢β^i,

gdzie tak jak przy liczeniu błędu predykcji na nowych danych, yi,xiT jest niezależne od yi,Xi.

Korzystając z tego, że E⁢y^i=E⁢yi=xiT⁢β, otrzymujemy:

E⁢y^i-yi2=Var⁢y^i-yi=σ2⁢1+xiT⁢XiT⁢Xi-1⁢xi=σ21-hi⁢i,

gdzie hi⁢i to i-ty wyraz na przekątnej macierzy daszkowej dla pełnej macierzy X: H=X⁢XT⁢X-1⁢XT. Fakt ostatniej równości w powyższym wzorze przyjmiemy bez dowodu.

Wniosek 8.6

Estymator błędu predykcji przy użyciu kroswalidacji leave-one-out można uprościć do wzoru:

y-y^()2n=1n⁢∑i=1nyi-y^i2=∑i=1nσ21-hi⁢i. (8.7)

8.6. Model liniowy przy założeniu normalności

Zamiast w modelu liniowym zakładać:

E⁢ε=0⁢,⁢Var⁢ε=σ2⁢In,

założymy:

ε∼N⁢0,σ2⁢In.

Dzięki takiemu sformułowaniu zadania, będziemy mogli znaleźć rozkłady estymatorów β^ i σ^2, co umożliwi wnioskowanie statystyczne na ich temat, na przykład kondtrukcję przedziałów ufności. Udowodnimy:

Twierdzenie 8.4 (Fishera)

Przy założeniu ε∼N⁢0,σ2⁢In, estymatory modelu liniowego spełniają:

  1. β^∼N⁢β,σ2⁢XT⁢X-1;

  2. β^ i σ^2=y-X⁢β^2n-p są niezależne;

  3. n-p⁢σ^2σ2∼χ2⁢n-p;

Ponieważ y=X⁢β+ε, mamy:

y∼N⁢X⁢β,σ2⁢In. (8.8)

Wiemy, że nieobciążonymi estymatorami parametrów modelu liniowego są:

β^=XT⁢X-1⁢XT⁢y⁢,⁢σ^2=y-X⁢β^2n-p.
  1. Korzystając z twierdzenia 7.1 oraz wzoru 8.8, możemy wywnioskować, że β^ ma rozkład normalny. Wartość oczekiwana estymatora (8.4) i wariancja (8.5) wyznaczają jednoznacznie rozkład.

  2. Przypomnijmy wzory 8.2 i 8.1:

    β^=R1-1⁢Q1T⁢y⁢,⁢y-X⁢β^2=Q2⁢y2.

    Wiemy z twierdzenia 7.1, że Q⁢y ma rozkład normalny. Policzmy macierz wariancji tego wektora losowego:

    Var⁢QT⁢y=QT⁢Var⁢y⁢Q=σ2⁢In. (8.9)

    Wiemy zatem, że wektory losowe Q1T⁢y i Q2T⁢y są nieskorelowane. Dla rozkładu normalnego brak korelacji jest równoważny niezależności.

  3. Rozkład χ2 z n-p stopniami swobody to suma n-p kwadratów niezależnych zmiennych losowych o rozkładzie standardowym normalnym. Udowodnimy, że σ^2⁢n-pσ2=y-X⁢β^2σ2=Q2T⁢y2σ2 ma rozkład χ2⁢n-p.

    Z rozkładu QR macierzy X znamy wymiary macierzy Q2, długość wektora Q2T⁢y to n-p. Oznaczmy:

    Q2T⁢y2=qp+1T⁢y2+…+qnT⁢y2=z12+…+zn-p2.

    Udowodnimy, że zi, i=1,…,n-p są niezależne i mają rozkład N⁢0,σ2.

    Współrzędne wektora Q2T⁢y są niezależnymi zmiennymi losowymi o rozkładzie normalnym. Normalność wynika z twierdzenia 8.2, niezależność z braku korelacji (8.9). Ze wzoru 8.9 widzimy także, że wariancje zi są równe σ2.

    Współrzędne wektora Q2T⁢y mają wartość oczekiwaną równą zero:

    E⁢Q2T⁢y=Q2T⁢E⁢y=Q2T⁢X⁢β=

    z wąskiego rozkładu QR macierzy X,

    =Q2T⁢Q1︸=0R1=0

    z ortogonalności kolumn macierzy Q.

    Otrzymujemy więc:

    z1σ2+…+zn-pσ2=Q2T⁢y2σ2∼χ2⁢n-p,

    gdzie ziσ są niezależnymi zmiennymi losowymi o rozkładzie N⁢0,1.

∎

8.7. Test ilorazu wiarygodności (Likelihood Ratio Test) hipotez liniowych

Hipotezy liniowe przy założeniach modelu liniowego można ogólnie sformułować jako:

⁡y=X⁢β+εA⁢β=0⁢

gdzie macierz X jest wymiaru n×p, a macierz A wymiaru p-q×p.

Przykład 8.1

Jeżeli wektor współczynników jest postaci:

β=β1β2β3β4

i chcemy nałożyć ograniczenie liniowe na parametry: β2=β3, to można go zapisać postaci:

01-10︸A⁢β=0.

8.7.1. LRT ogólnie

Ogólnie test ilorazu wiarygodności dotyczący parametru θ rozkładu zmiennej losowej X można zapisać jako:

H0: ⁢X∼fθ⁢x⁢ , ⁢θ∈Θ0;
H1: ⁢X∼fθ⁢x⁢ , ⁢θ∈Θ1=Θ∖Θ0;

gdzie fθ⁢x oznacza gęstość rozkładu zmiennej X zależącą od parametru θ.

Statystyka testowa wyraża się wzorem:

λ⁢x=supθ∈Θ1⁡fθ⁢xsupθ∈Θ0⁡fθ⁢x=fθ^⁢x⁢xfθ˙⁢x⁢x,

gdzie:

θ^⁢ to estymator największej wiarygodności dla ⁢θ∈Θ1;
θ˙⁢ to estymator największej wiarygodności dla ⁢θ∈Θ0.
Uwaga 8.1

Jeżeli fθ⁢x=∏i=1nfθ⁢xi to:

log⁡λ⁢x=∑i=1nlog⁡fθ^⁢x⁢x-∑i=1nlog⁡fθ˙⁢x⁢x.

8.7.2. Modele zagnieżdżone

Z modelem zagnieżdżonym mamy do czynienia gdy Θ0⊆Θ.

Rozpatrzmy następujący problem:

Θ⊆Rp,⁢h:Rp→Rp-q,⁢Θ0=θ:h⁢θ=0.

Dla hipotez liniowych mamy:

h⁢θ=A⁢θ=0,

wtedy typowo Θ0⊆Rq, skąd możemy zapisać:

supθ∈Θ1⁡fθ⁢x=supθ∈Θ⁡fθ⁢x.

Dzięki takiemu zapisowi upraszcza się wzór na statystykę testową LRT:

λ⁢x=supθ∈Θ⁡fθ⁢xsupθ∈Θ0⁡fθ⁢x.
Twierdzenie 8.5 (Asymptotyczny rozkład LRT)

Przy założeniach: Θ⊆Rp otwarty, fθ⁢x regularna rodzina gęstości, h:Rp→Rp-q funkcja gładka, Θ0=θ:h⁢θ=0:

∀θ∈Θ0⁢⁢∀t⁢⁢Pθ2⁢log⁡λ⁢x≤t→Fχ2⁢p-q⁢t,

gdzie Fχ2⁢p-q oznacza dystrybuantę rozkładu χ2 o p-q stopniach swobody.

8.7.3. LRT w modelu liniowym

Wracamy teraz do modelu linowego i zakładamy normalność rozkładu ε:

⁡y=X⁢β+εA⁢β=0⁢

gdzie X ma wymiary n×p, A wymiary p-q×p;

ε∼N⁢0,σ2⁢In.

Dla tak sformułowanego zadania wiemy, że rozkład danych y jest normalny i wyraża się wzorem:

fθ⁢y=12⁢π⁢σ2n2⁢exp⁡-y-X⁢β22⁢σ2,

gdzie θ=β1,…,βp,σ2.

Stwierdzenie 8.7

Statystyka testowa testu ilorazu wiarygodności dla H0:A⁢β=0 jest równa:

λ⁢y=σ˙2σ^2n2=y-X⁢β˙2y-X⁢β^2n2, (8.10)

gdzie:

θ^=β^,σ^2⁢ estymatory największej wiarygodności bez ograniczeń (na zbiorze Θ);
θ˙=β˙,σ˙2⁢ estymatory największej wiarygodności z ograniczeniami
(A⁢β=0, na zbiorze Θ0).
λ⁢y=fθ^⁢y⁢yfθ˙⁢y⁢y=12⁢πn⁢1σ^2n2⁢exp⁡-12⁢y-X⁢β^2σ^212⁢πn⁢1σ˙2n2⁢exp⁡-12⁢y-X⁢β˙2σ˙2=♣

korzystając z postać estymatora największej wiarygodności dla parametru σ2 w modelu liniowym, możemy zapisać:

σ^2=y-X⁢β^2n⁢,⁢σ˙2=y-X⁢β˙2n;

pdstawiając otrzymujemy:

♣=1σ^2n2⁢exp⁡-12⁢σ^2n⁢σ^21σ˙2n2⁢exp⁡-12⁢σ˙2n⁢σ˙2=σ˙2σ^2n2.
∎
Stwierdzenie 8.8

Statystyka testowa

λ⁢y=σ˙2σ^2n2

jest równoważna statystyce:

F=R0-R/p-qR/n-p,

gdzie R0=y-X⁢β˙2, R=y-X⁢β^2.

Ze wzoru 8.10 widzimy, że:

λ⁢y=R0Rn2.

Statystyka λ jako iloraz norm dwóch wektorów, jest nieujemna, a dla p<n dodatnia z dodatniości R i R0. Istnieje rosnące przekształcenie λ w F dla λ>0, więc statystyki są rónoważne.

∎
Twierdzenie 8.6

Statystyka F przy p≪n ma rozkład F-Snedecora:

F=R0-R/p-qR/n-p∼F⁢p-q,n-p.

Zmieńmy oznaczenia dotyczące macierzy planu. Macierz X=x1,…,xp gdzie xi będą oznaczać kolumny macierzy, zwane predyktorami. Możemy wtedy zapisac:

y=X⁢β+ε=x1⁢β1+…+xp⁢βp+ε.

Wiemy, że:

Xβ^∈L={Xβ=x1β1+…+xpβp, β∈Rp};
Xβ˙∈L0={Xβ : Aβ=0};

gdzie

L0⊆L⊆Rn,

przestrzenie L0 i L0 są przestrzeniami liniowymi o wymiarach:

dim⁢L0︸=q<dim⁢L︸=p≪n.

Ortogonalizujemy bazę przestrzeni L0, uzupełniamy do bazy L, a następnie do bazy Rn. Oznaczmy:

V=v1,…,vq︸baza ⁢L0,vq+1,…,vp︸baza ⁢L,vp+1,…,vn.

oraz:

Z=VT⁢y,⁢Z^=VT⁢X⁢β^,⁢Z˙=VT⁢X⁢β˙.

Zauważmy, że wektory te są postaci:

Z=z1…zq…zp……zn⁢⁢Z^=z^1…z^q…z^p0…0⁢⁢Z˙=z˙1…z˙q0………0.

Możemy wtedy zapisać:

R=y-X⁢β^2=

ponieważ mnożenie wektora przez macierz ortogonalną nie zmienia jego normy,

=||VT(y-Xβ^)||2=||Z-Z^||2;
R=y-X⁢β˙2=VT⁢y-X⁢β˙2=Z-Z˙2.

Najlepszymi dopasowaniami Z˙ do Z oraz Z^ do Z minimalizującymi błędy średniokwadratowe R0 i R są:

Z˙=z˙1=z1…z˙q=zq0……0⁢⁢Z^=z^1=z1……z^p=zp0…0

Stąd:

R0=zq+12+…+zp2+…+zn2;
R=zp+12+…+zn2.

Ponieważ założyliśmy rozkład normalny dla ε, możemy zapisać:

y∼N⁢X⁢β,σ2⁢In,

a także, ponieważ V jest macierzą ortogonalną:

Z=VT⁢y∼N⁢VT⁢X⁢β,σ2⁢In. (8.11)

Współrzędne wektora Z: z1,…,zn mają więc rozkłady normalne i są niezależne (bo nieskorelowane). Co więcej, przy założeniu hipotezy zerowej, X⁢β∈L0, czyli jest postaci:

X⁢β=w1…wq0…0

w bazie V. Ze wzoru 8.11, E⁢Z=VT⁢X⁢β, czyli:

E⁢zq+1=…=E⁢zn=0.

Widzimy teraz, że wyrażenie:

R0-Rσ2=zq+1σ2+…+zpσ2

ma rozkład χ(p-q), a wyrażenie:

Rσ2=zp+1σ2+…+znσ2

rozkład χ(n-p) oraz oba wyrażenia są od siebie ziezależne. Wróćmy do postaci statystyki F:

F=R0-R/p-qR/n-p=zq+12+…+zp2/p-qzp+12+…+zn2/n-p

ma więc rozkład F⁢p-q,n-p.

∎
Uwaga 8.2

Zauważmy ciekawą własność bazującą na dowodzie twierdzenia: dla H0: β1=…=βp=0 przy modelu postaci:

y=11⋆…1⁢β0β1…βp+ε,

możemy zapisać:

y-y¯⁢1n︸=X⁢β˙2=y-y^︸=X⁢β^2+y^-y¯⁢1n2,

gdzie y¯ jest średnią arytmetyczną z obserwacji w wektorze y.

Wniosek 8.7

Testowanie hipotez o istotności współczynników (testowanie hipotez, czy kolejne grupy βi są równe zeru) służy wyborowi modelu (podzbioru zmiennych objaśniających x1,…,xp).

8.8. Popularne kryteria wyboru modelu – kryteria informacyjne

W poprzednim rozdziale zostało opisane testowanie hipotez o istotności współczynników jako sposób wyboru modelu. Wybór predyktorów można także oprzeć na minimalizacji estymatora błędu predykcji wyliczonego na podstawie kroswalidacji leave-one-out (8.7). Opiszemy teraz jeszcze inną metodę wyboru zmiennych objaśniających bazującą na tak zwanych kryteriach informacyjnych postaci:

kryterium = -2⋅logwiarygodność + kara za złożoność modelu,

które obliczane są dla każdego modelu (dla każdego podzbioru p predyktorów) i wybierany jest ten minimalnej wartości kryterium. Dwa popularne kryteria informacyjne:

  1. Akaike Information Criterion (AIC):

    A⁢I⁢C= -2⋅loglik +2⋅p,

    gdzie p to liczba zmiennych objaśniających w modelu.

  2. Bayes Information Criterion (BIC):

    B⁢I⁢C= -2⋅loglik +log⁡n⋅p,

    gdzie n to liczba obserwacji w modelu.

Przy założeniach modelu liniowego i normalności rozkładu ε∼N⁢0,σ2⁢In, kryteria przyjmują łatwiejszą postać:

  1. Przy znanym σ2:

    A⁢I⁢C=y-y^2σ2+2⋅p;
    B⁢I⁢C=y-y^2σ2+log⁡n⋅p;
  2. Przy nieznanym σ2:

    A⁢I⁢C=n⁢log⁡y-y^2n+2⋅p;
    B⁢I⁢C=n⁢log⁡y-y^2n+log⁡n⋅p;

8.9. Model logistyczny – przykład uogólnionego modelu liniowego

Modelu logistycznego używa się do objaśniania zmiennej binarnej, czyli przyjmującej wartości ze zbioru 0,1. Poprzednio zakładaliśmy:

yi∼N⁢xiT⁢β,σ2,⁢yi⁢ niezależne ⁢i=1,…,n,

gdzie wektor xi oznacza wiersz macerzy planu.

Teraz będziemy zakładać rozkład:

yi∼B⁢1,p⁢xi︸rozkład Bernoulliego=B⁢1,exp⁡xiT⁢β1+exp⁡xiT⁢β,⁢yi⁢ niezależne ⁢i=1,…,n,

gdzie postać funkcji p⁢xi można tłumaczyć tym, że prawdopodobieństwo powinno przyjmować wartości z przedziału 0,1. Parametry modelu (β) estymuje się metodą największej wiarygodności, gdzie funkcja wiarygodności jest równa:

L⁢β=∏i=1np⁢xiyi⁢1-p⁢xi1-yi=∏i=1nexp⁡yi⁢xiT⁢β1+exp⁡xiT⁢β.

Logarytm funkcji wiarygodności maksymalizuje się numerycznie aby otrzymać estymatory β^. Predykcję w modelu można oprzeć na klasyfikatorze:

t=xn+1T⁢β^,

gdzie xn+1 jest wektorem nowych obserwacji. Przewidywany na podstawie modelu y^n+1 to wtedy:

y^n+1=⁡1,t≥0  (wtedy p⁢xn+1≥12);0,t<0  (wtedy p⁢xn+1<12).⁢

8.10. Przykłady w programie R

Model liniowy:

Logit (model logistyczny):

Treść automatycznie generowana z plików źródłowych LaTeXa za pomocą oprogramowania wykorzystującego LaTeXML.

Projekt współfinansowany przez Unię Europejską w ramach Europejskiego Funduszu Społecznego.

Projekt współfinansowany przez Ministerstwo Nauki i Szkolnictwa Wyższego i przez Uniwersytet Warszawski.